


 العربية
 English
استخراج بيانات الكتب من المواقع باستخدام Python وWeb Scraping
منذ أسبوع
عرض العمل
الوصف
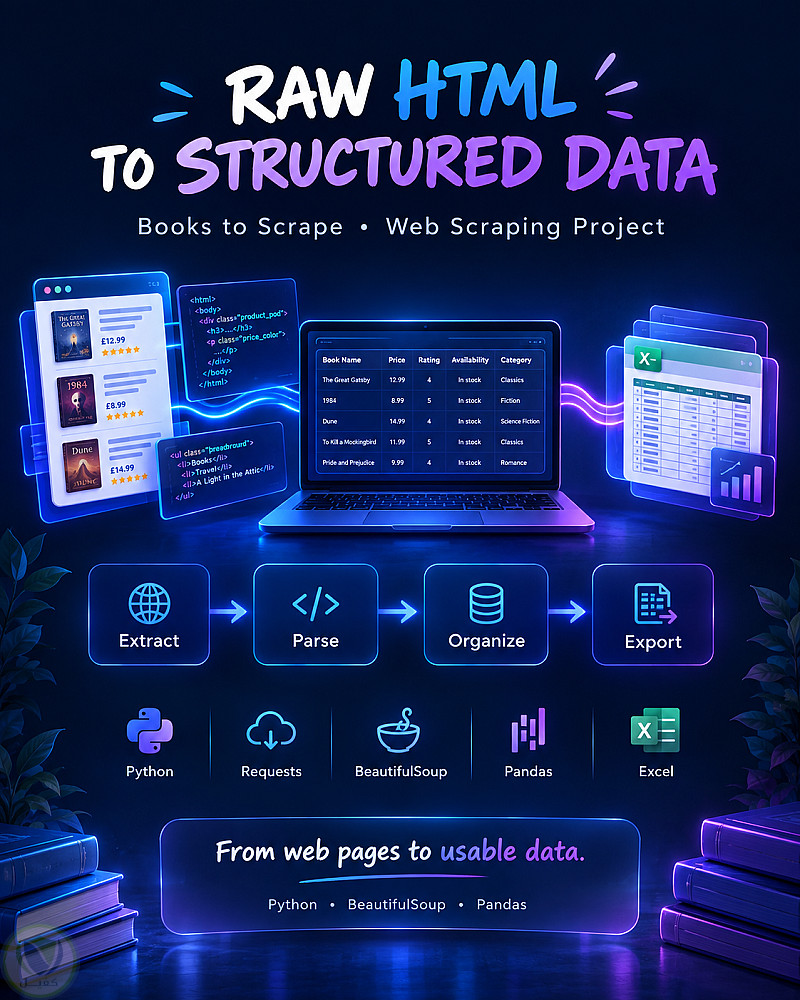
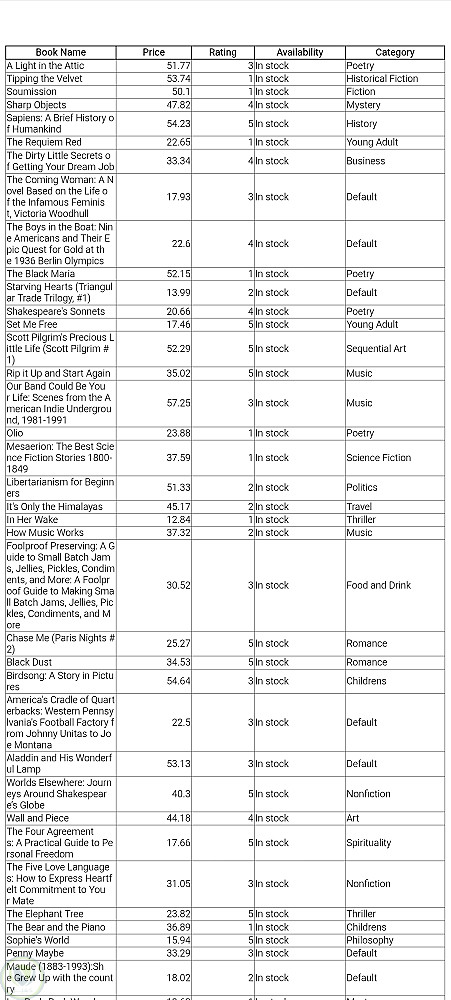
قمت بتطوير مشروع Web Scraping باستخدام Python لجمع بيانات الكتب من موقع Books to Scrape وتحويلها إلى بيانات منظمة يسهل التعامل معها وتحليلها.
المشروع بيشمل:
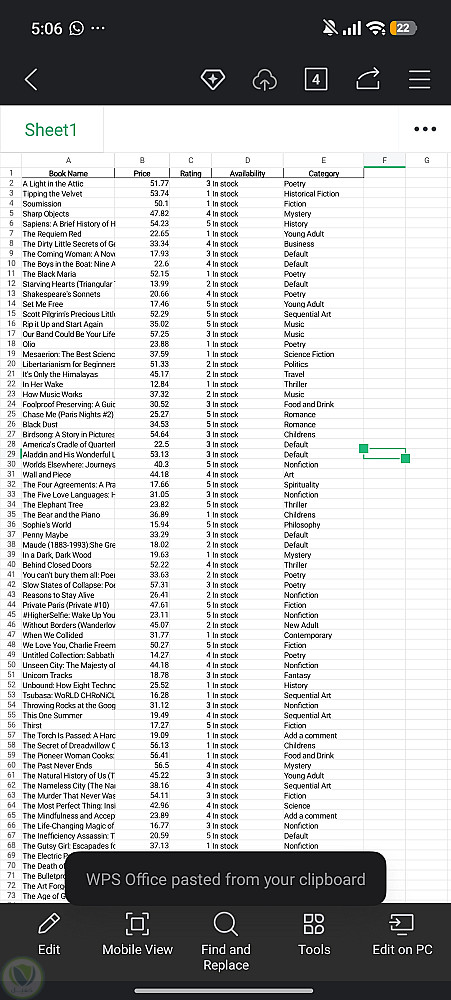
- استخراج أسماء الكتب وأسعارها وتقييماتها وحالة توافرها.
- جمع تصنيفات الكتب من صفحات التفاصيل الخاصة بكل كتاب.
- استخدام BeautifulSoup لتحليل HTML واستخراج البيانات المطلوبة.
- استخدام Requests لجلب صفحات الموقع والتنقل بين صفحات الكتب.
-استخدام Pandas لتنظيم البيانات في DataFrame.
تصدير البيانات النهائية إلى ملف Excel لاستخدامها في التحليل والمعالجة لاحقًا.
التقنيات المستخدمة:
Python, Requests, BeautifulSoup, Pandas, Excel
النتيجة:
سكريبت قابل لإعادة التشغيل لجمع بيانات الكتب من صفحات متعددة وتحويلها إلى Dataset منظمة بدلًا من جمع البيانات يدويًا.
التفاصيل
| المشاهدات | 2 |
| المفضلة | 0 |
| القسم | برمجة, تطوير المواقع و التطبيقات - مواقع الويب |
حساب المستخدم

بائع مستوي: جديد
مهندس بيانات
| اخر ظهور: منذ 5 أيام
أنا متخصص في هندسة البيانات (Data Engineering)، ولدي خلفية في تطوير البرمجيات تساعدني على بناء حلول عملية ومنظمة لجمع البيانات وتنظيفها وتحويلها إلى بيانات ....
وظفني