


 العربية
 English
هندسة ومعالجة البيانات الضخمة لسوق Steam: نظام ETL متكامل باستخدام Spark و Hadoop
منذ 3 أشهر
عرض العمل
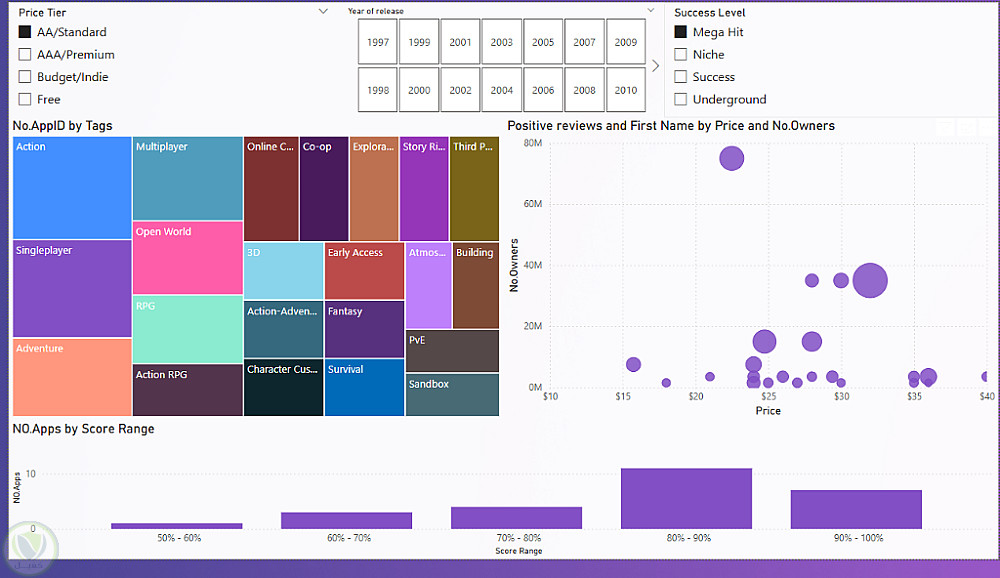
الوصف
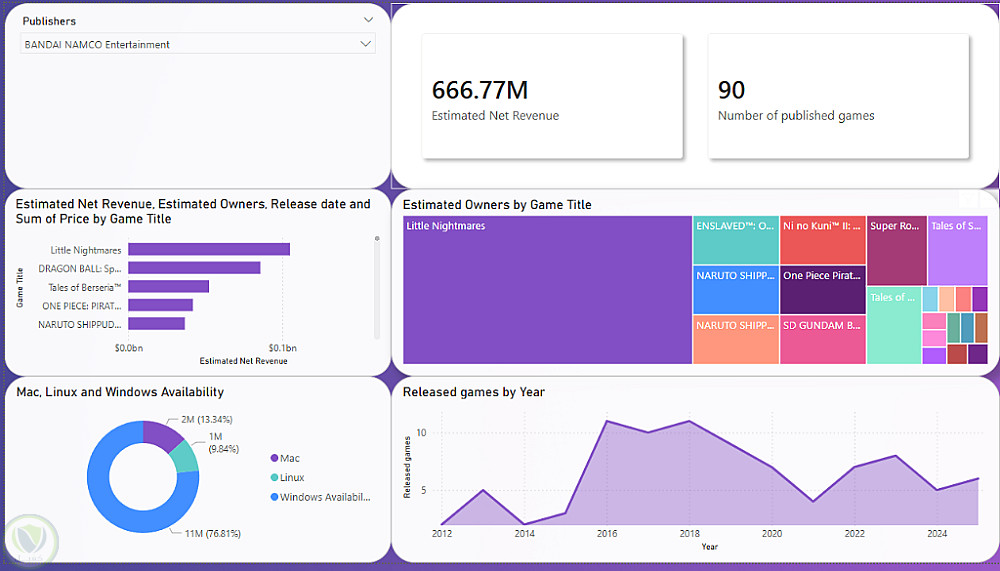
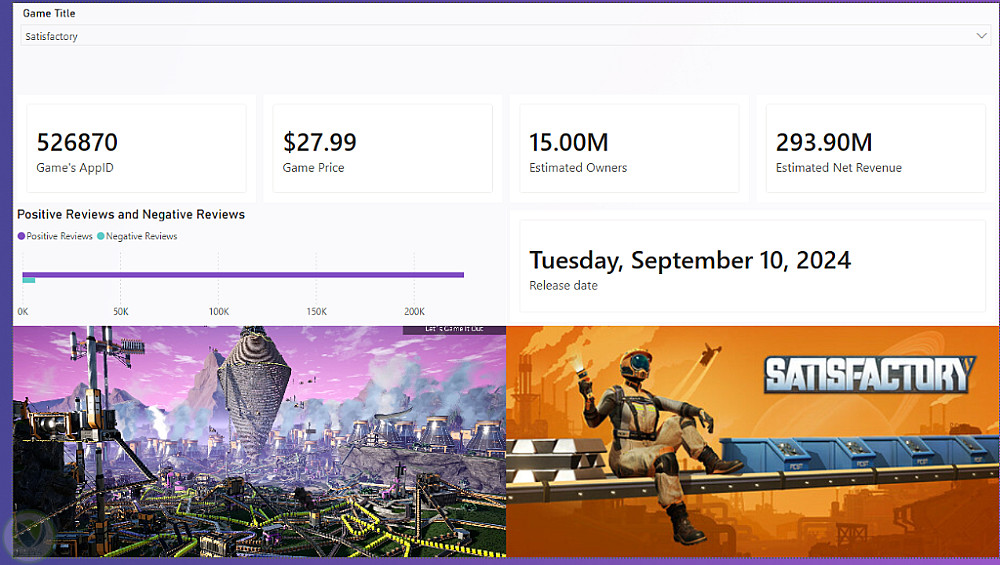
يتناول هذا المشروع التحدي التقني المتمثل في التعامل مع بيانات سوق "Steam" التي تمتاز بالسرعة والضخامة. قمت ببناء بيئة عمل متكاملة تعتمد على تقنيات Big Data لتحويل ملايين السجلات الخام إلى معلومات منظمة وقابلة للتحليل الاستراتيجي.
أبرز ملامح العمل التقني:
بدلاً من الاعتماد على المعالجة التقليدية، استخدمت قوة Apache Spark لتوزيع عمليات التنظيف والتحليل على عدة وحدات معالجة، مما يقلل وقت التنفيذ من ساعات إلى دقائق معدودة.
بنية تحتية مرنة باستخدام Docker: قمت بتنفيذ النظام بالكامل داخل حاويات Docker، بما في ذلك عُقد (Nodes) الـ Hadoop والـ Spark، مما يضمن استقرار النظام وسهولة نقله أو توسيعه مستقبلاً ليشمل خوادم متعددة.
تم استخدام نظام ملفات Hadoop (HDFS) كطبقة تخزين وسيطة للبيانات غير المنظمة، مما يوفر قدرة عالية على استرجاع البيانات وتحمل الأخطاء البرمجية (Fault Tolerance).
يبدأ النظام باستخراج بيانات السوق، مروراً بمراحل التصفية والهيكلة المعقدة، وانتهاءً بتخزينها في قاعدة بيانات PostgreSQL بشكل مهيأ تماماً لعمليات الاستعلام المتقدمة ولوحات المعلومات (Dashboards).
التفاصيل
| المشاهدات | 13 |
| المفضلة | 0 |
| القسم | برمجة, تطوير المواقع و التطبيقات - اخري |
حساب المستخدم

بائع مستوي: جديد
مهندس بيانات
| اخر ظهور: منذ 3 أيام
أنا مهندس بيانات ومطور حلول تقنية، شغلتي الأساسية إني آخد الداتا الخام والملخبطة وأحولها لأصول رقمية منظمة تساعدك تاخد قرارات صح. بدل الطريقة التقليدية الل ....
وظفني