 العربية
 English
بناء وتطوير نماذج الذكاء الاصطناعي والتعلم الآلي (Machine Learning) باستخدام Python
الوصف
هل تبحث عن تحويل بياناتك إلى رؤى واستنتاجات دقيقة، أو بناء نموذج ذكاء اصطناعي (Machine Learning Model) موثوق يعالج مشاكلك البرمجية أو الاستثمارية؟
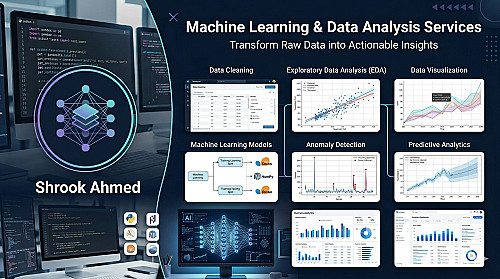
أقدم لك خدمة متكاملة لبناء وتحليل نماذج التعلم الآلي باستخدام أحدث مكتبات لغة Python. أضمن لك الحصول على كود منظم، مفسر، ونتائج دقيقة قابلة للتطبيق العملي، مع دعم بصري ممتاز للبيانات عبر رسوم بيانية تفاعلية وجذابة.
مميزات الخدمة:
تنظيف وتحضير البيانات (Data Preprocessing): التعامل مع القيم المفقودة (Missing Values)، القيم الشاذة (Outliers)، وتشفير المتغيرات النصية (Categorical Encoding).
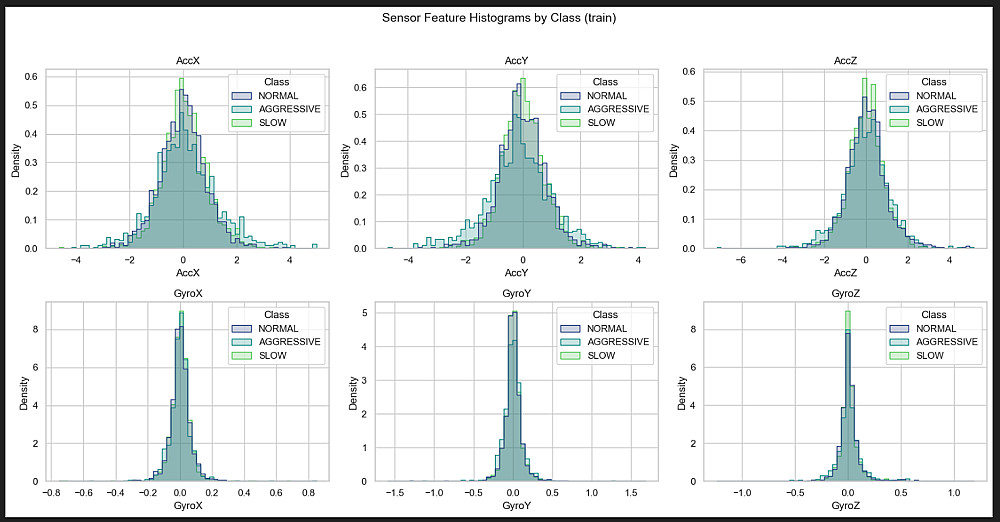
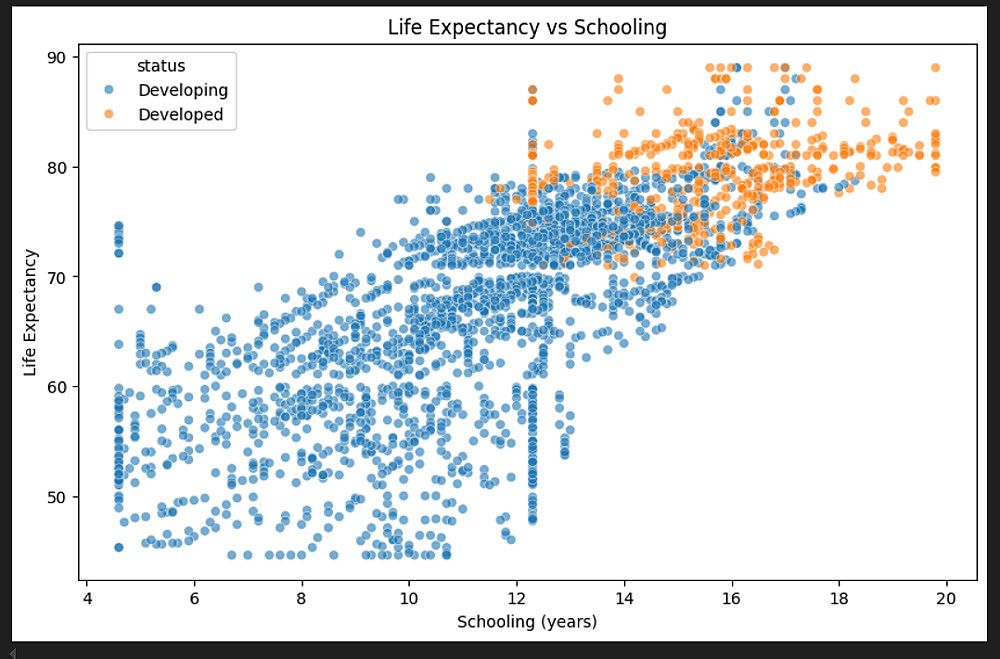
التحليل الاستكشافي (EDA): استخراج أنماط البيانات والعلاقات بين المتغيرات باستخدام أدوات التمثيل البصري.
بناء وتقييم النماذج: اختيار وبناء خوارزمية التعلم الآلي الأنسب لمشكلتك (التصنيف Classification، الانحدار Regression، أو التجميع Clustering).
ضبط المعايير (Hyperparameter Tuning): رفع كفاءة النموذج للحصول على أعلى دقة ممكنة وتفادي فرط التخصيص (Overfitting).
تقارير وتصورات تفاعلية: تقديم الرسوم البيانية في صيغة صور عالية الدقة أو شاشات تفاعلية استكشافية.
المكتبات والتقنيات المستخدمة
المجال المكتبات والتقنيات المستخدمة
معالجة وتحليل البيانات Pandas, NumPy
التمثيل البصري والرسوم البيانية Matplotlib, Seaborn, Plotly
تطوير نماذج التعلم الآلي Scikit Learn
بيئات التنفيذ والتسليم Jupyter Notebook, Google Colab, Python Scripts (.py)
خطوات العمل والتنفيذ التفصيلية
1. فهم المشكلة ونطاق المشروع: تحديد الأهداف والمتطلبات المتوقعة.
تحليل هدف المشروع، تحديد نوع المسألة (Supervised / Unsupervised Learning)، ومعرفة متطلبات المشتري من حيث الدقة وزمن الاستجابة.
2. معالجة البيانات واستكشافها (EDA & Preprocessing): إعداد البيانات لرفع جودة النموذج.
تنظيف البيانات من الأخطاء والتكرارات.
معالجة القيم الشاذة والمفقودة.
معالجة الفروق بين مقاييس البيانات (Feature Scaling / Normalization).
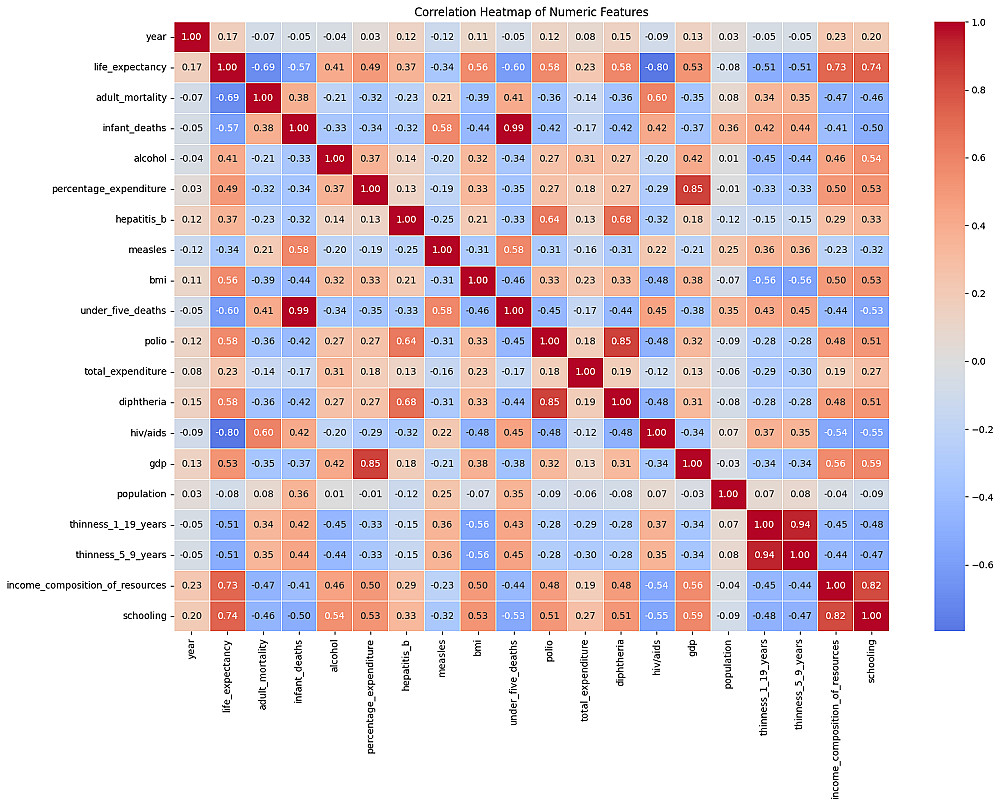
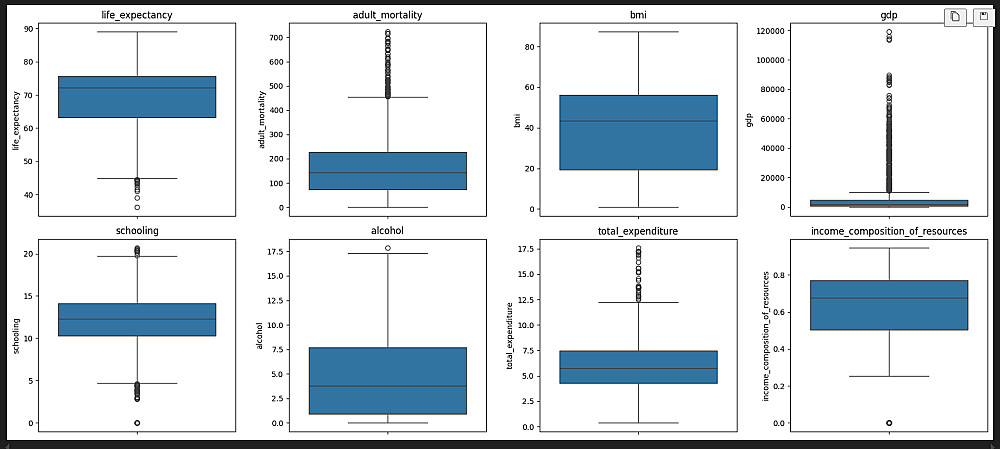
إنشاء رسم بياني شامل للعلاقات بين البيانات (Correlation Heatmaps, Boxplots, Scatterplots) باستخدام Seaborn و Plotly.
3. بناء وتدريب النماذج (Model Building): تطبيق خوارزميات Scikit Learn.
تقسيم البيانات إلى مجموعات تدريب واختبار (Train/Test Split & Cross Validation).
اختيار عدة خوارزميات مثل: (Logistic Regression, Decision Trees, Random Forest, SVM, KNN, Gradient Boosting).
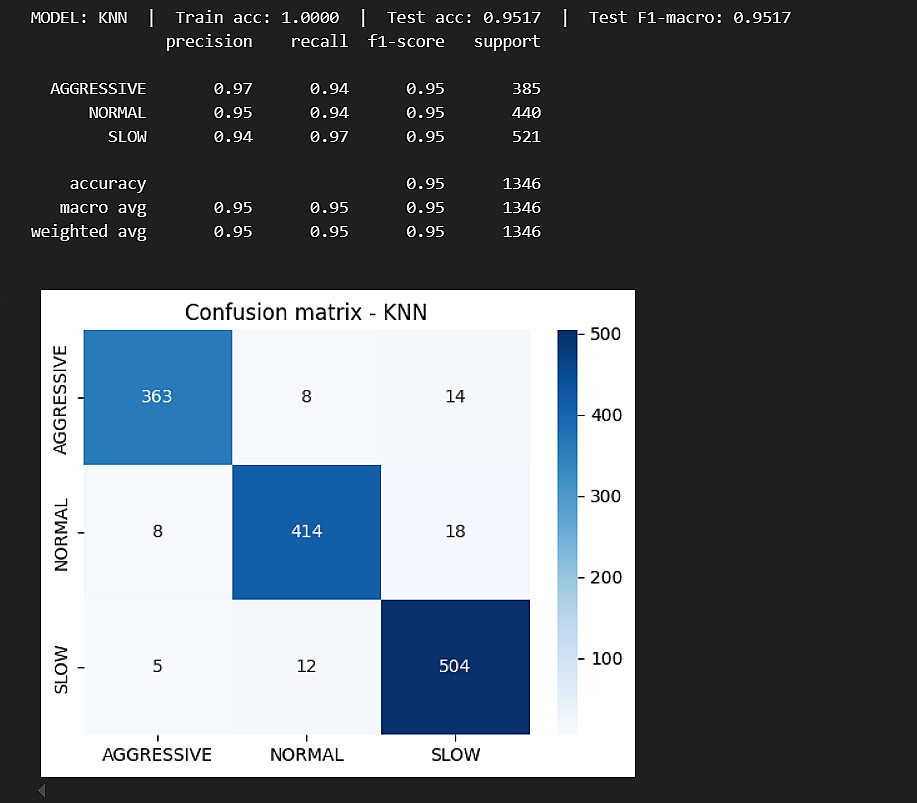
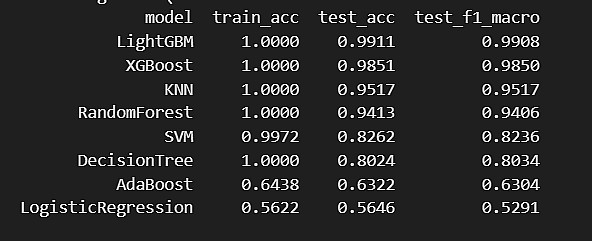
مقارنة أداء النماذج باستخدام المقاييس المناسبة (Accuracy, Precision, Recall, F1 Score, RMSE, R²).
4. تحسين الأداء وضبط المعلمات (Hyperparameter Tuning): الوصول لأفضل أداء ممكن للنموذج.
تطبيق تقنيات مثل GridSearchCV أو RandomizedSearchCV للوصول لأفضل معايير تجعل النموذج يعمل بأعلى كفاءة ودقة.
5. تسليم المخرجات والتوثيق: تسليم ملفات منظمة ومكتوبة بوضوح.
تسليم الكود المصدري كاملاً ومرفقاً بشروحات وتعليقات (Comments).
تقديم تقرير شامل لنتائج النموذج والرسوم البيانية التفاعلية.
البائع
معلومات

الخدمات المقترحه