


 العربية
 English
التعامل مع مودل الذكاء الاصطناعي وتنظيف ومعالجة البيانات (Data Preprocessing): معالجة القيم المفقودة
الوصف
مرحبا بك!
هل تبحث عن تحويل بياناتك المعقدة إلى قرارات ذكية ونماذج تنبؤية دقيقة؟ أقدم لك خدمة متكاملة في تطوير حلول التعلم الآلي وتحليل البيانات، لمساعدتك في استخراج قيمة حقيقية من بياناتك وتطبيقها في عملك.
ما الذي أقدمه لك في هذه الخدمة؟
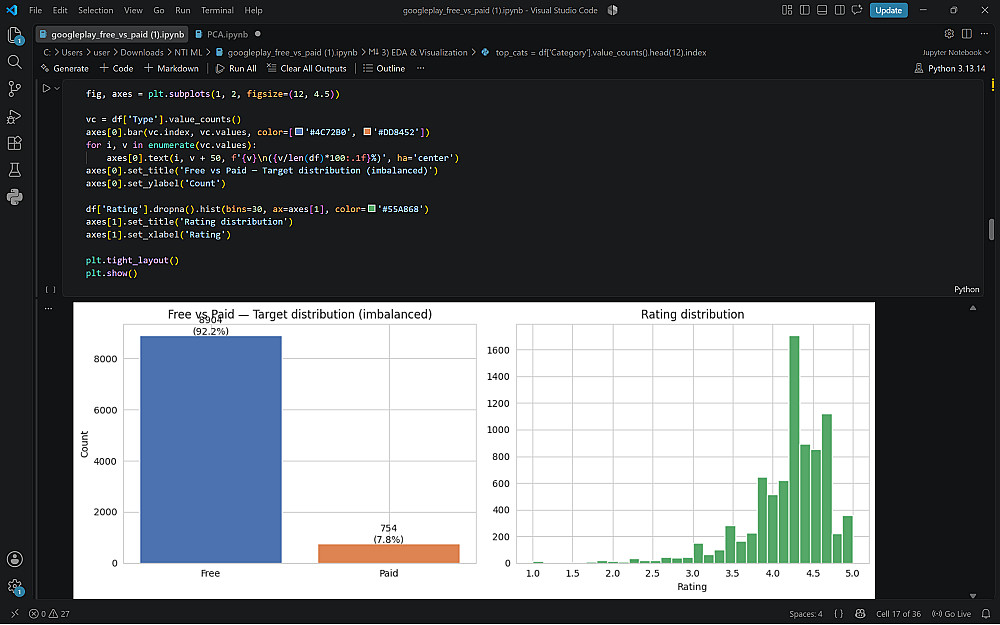
تنظيف ومعالجة البيانات (Data Preprocessing): معالجة البيانات المفقودة، القيم الشاذة، وتهيئتها بشكل مثالي للتدريب.
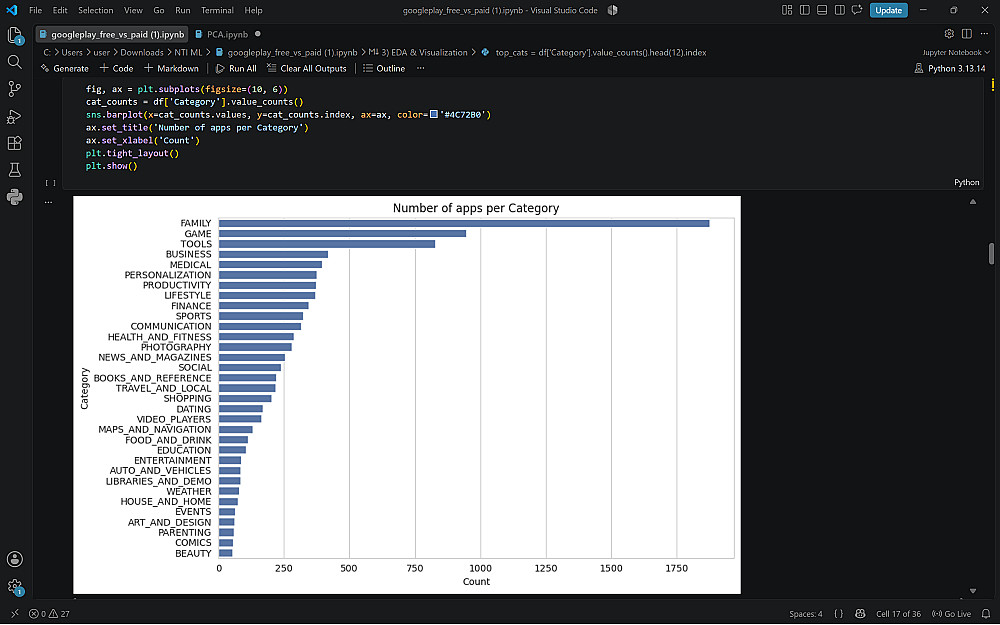
التحليل الاستكشافي للبيانات (EDA): استخراج الأنماط والرؤى العملية وتلخيص سلوك البيانات.
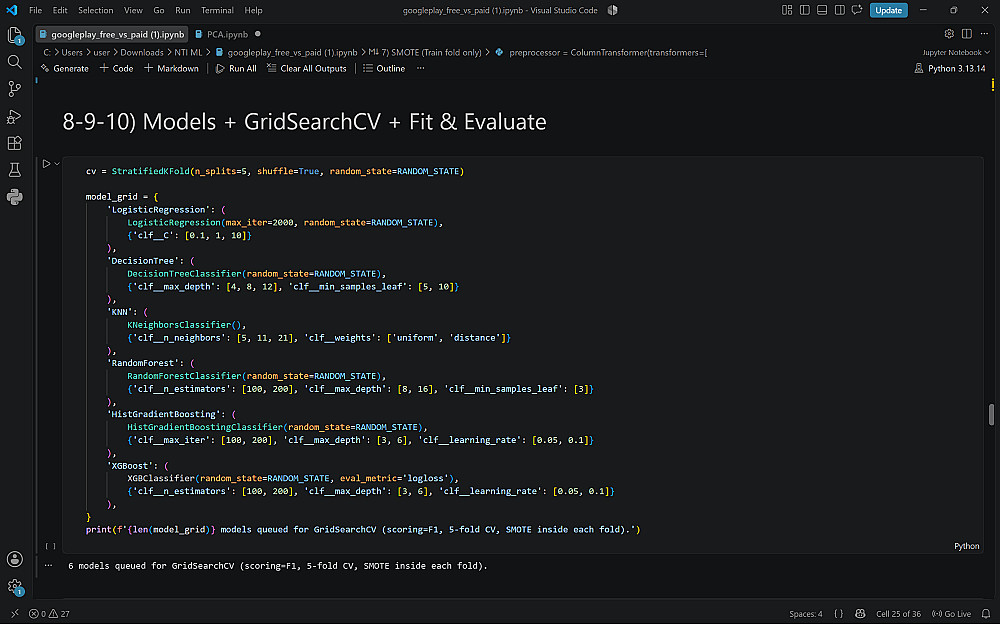
بناء وتدريب النماذج التنبؤية: تطوير نماذج التصنيف (Classification) والتنبؤ (Regression) باستخدام أفضل مكتبات Python مثل Pandas وNumPy وScikit-Learn.
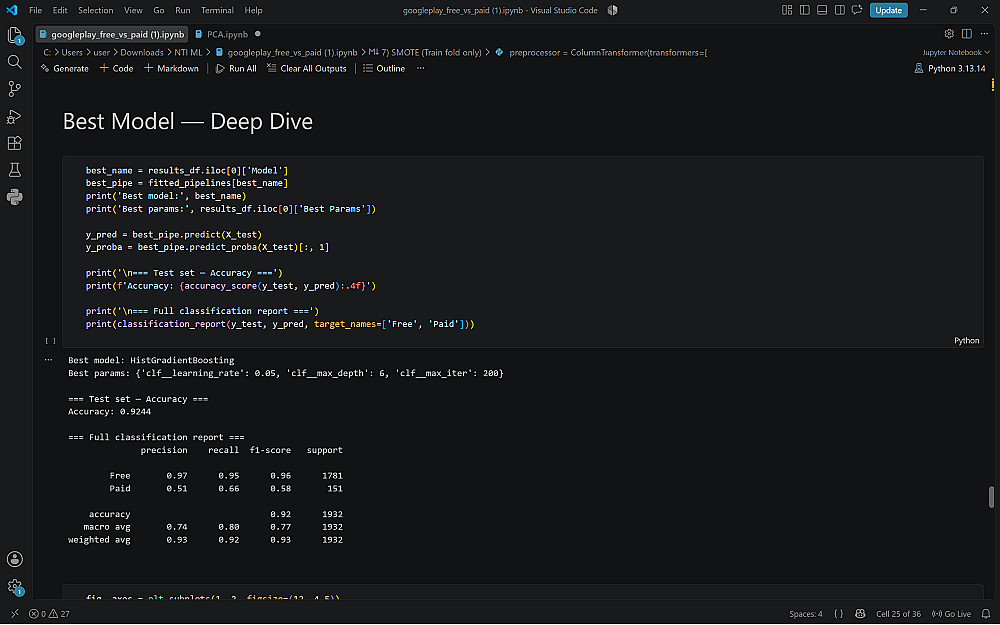
تقييم وتحسين الأداء (Model Optimization): ضبط المعاملات (Hyperparameter Tuning) للوصول لأعلى دقة ممكنة وموثوقية في النتائج.
الميزة التنافسية (USP):
الدقة الهندسية والالتزام بالكود النظيف: أجمع بين التفكير التحليلي لمهندس الاتصالات وكتابة كود برمجي نظيف (Clean Code) ومُوثّق بالكامل، مما يضمن لك ليس مجرد نموذج يعمل، بل حل برمجي مُنظّم وسهل الفهم والتطوير مستقبلاً دون أي تعقيد تقني.
حجم البيانات (Dataset Size):
"تواصل معي الآن، ودعنا نحول بياناتك إلى نظام تنبؤي دقيق يخدم أهداف مشروعك بفاعلية!"
التعامل مع ملف بيانات يحتوي على ما يصل إلى 10,000 سطر (Rows) وبحد أقصى 15 إلى 20 ميجابايت (للبيانات المجدولة Tabular Data مثل CSV / Excel).
(للبينات الضخمة أو الأكبر حجماً، يمكنك اختيار تطويرات الخدمة)
مقارنة النماذج (Models Comparison):
إجراء تقييم ومقارنة شاملة لـ 5 إلى 8 خوارزميات وموديلات تعلم آلي مختلفة تناسب طبيعة بياناتك (تتضمن النماذج الكلاسيكية والنماذج التجميعية Ensemble Models مثل: Random Forest, XGBoost, LightGBM, Decision Trees, SVM, KNN, Logistic/Linear Regression)، مع تحليل دقيق لأداء كل نموذج لاختيار واعتتماد الموديل الأعلى دقة وكفاءة (Best Performing Model) لمشروعك.
البائع

معلومات
الخدمات المقترحه


