 العربية
 English
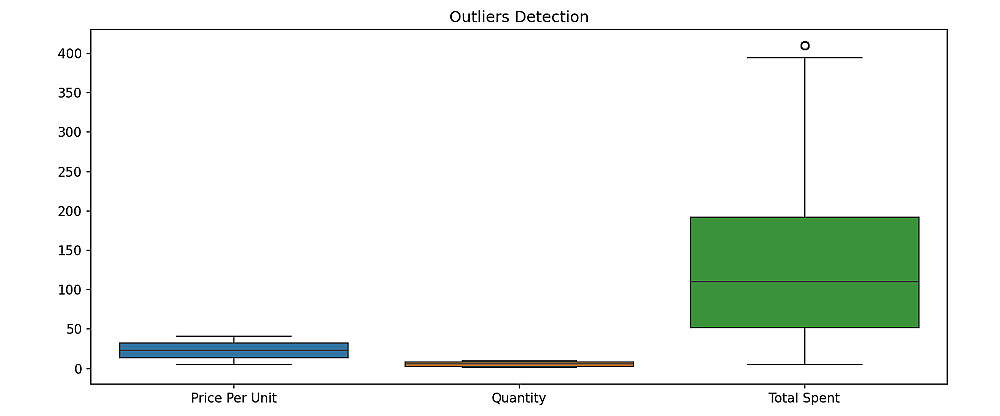
تنظيف وتجهيز البيانات (Data Preprocessing & Cleaning): معالجة القيم المفقودة (Missing Values) والتعامل مع البيانات الشا
الوصف
التحليل الاستكشافي للبيانات (EDA):
استخراج الأنماط والعلاقات بين المتغيرات باستخدام المخططات والرسوم البيانية.
فهم توزيع البيانات وتقييم جودتها قبل النمذجة.
هندسة وتحسين الميزات (Feature Engineering & Selection):
اختيار المتغيرات الأكثر تأثيراً على النتائج.
تطبيق مقياس الميزات (Feature Scaling & Normalization) وضبط الأبعاد (PCA عند الحاجة).
بناء وتدريب الخوارزميات (Model Building & Training):
نماذج التنبؤ والتصنيف (Supervised Learning): مثل Linear/Logistic Regression, Decision Trees, Random Forest, XGBoost, Support Vector Machines.
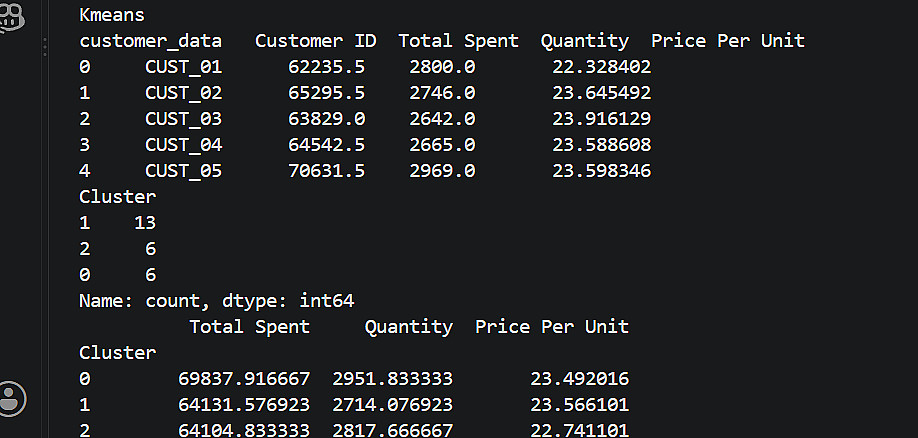
نماذج التجميع والتقسيم (Unsupervised Learning): مثل K-Means Clustering لتقسيم العملاء أو البيانات.
تقييم الأداء والضبط الدقيق (Evaluation & Hyperparameter Tuning):
تحسين أداء النموذج عبر Grid Search أو Random Search.
قياس الدقة باستخدام المقاييس المناسبة لكل مشكلة (Accuracy, Precision, Recall, F1-Score, ROC-AUC, RMSE).
التسليم والتوثيق (Deliverables):
كود Python نظيف ومنظم داخل ملف Jupyter Notebook أو Script مكتوب بقواعد احترافية.
ملف شرح توثيقي للنتائج وكيفية تشغيل النموذج واستخدامه.
البائع
معلومات
الخدمات المقترحه