


 العربية
 English
استخراج وتحليل 567 ألف خبر عربي باستخدام Python Web Scraping | مشروع فائز في UGRF
منذ 12 ساعة
عرض العمل
الوصف
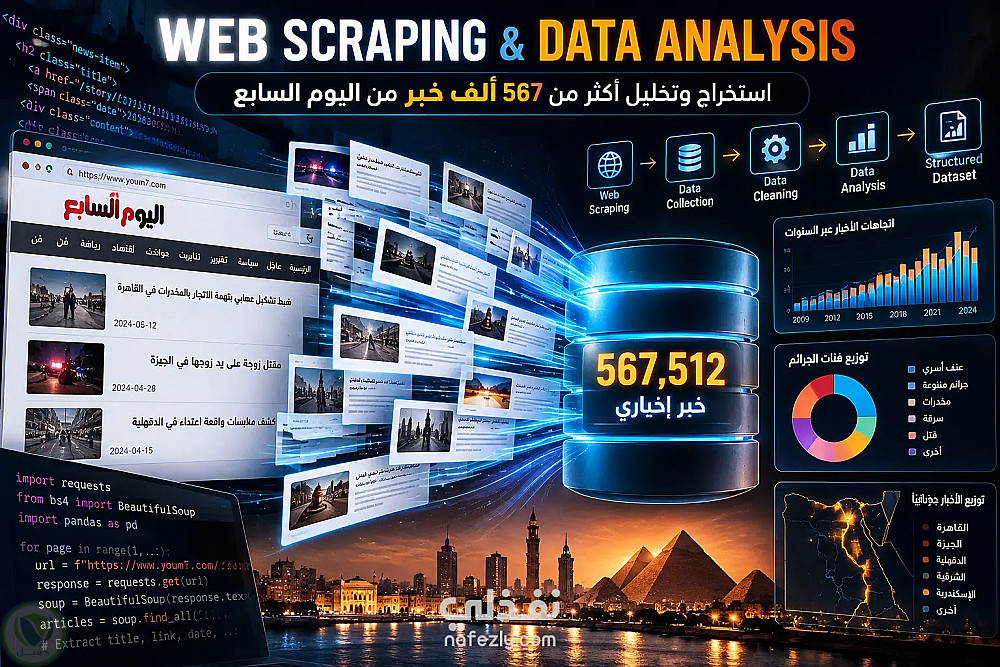
567,512 خبر عربي | مشروع بحثي فائز في UGRF
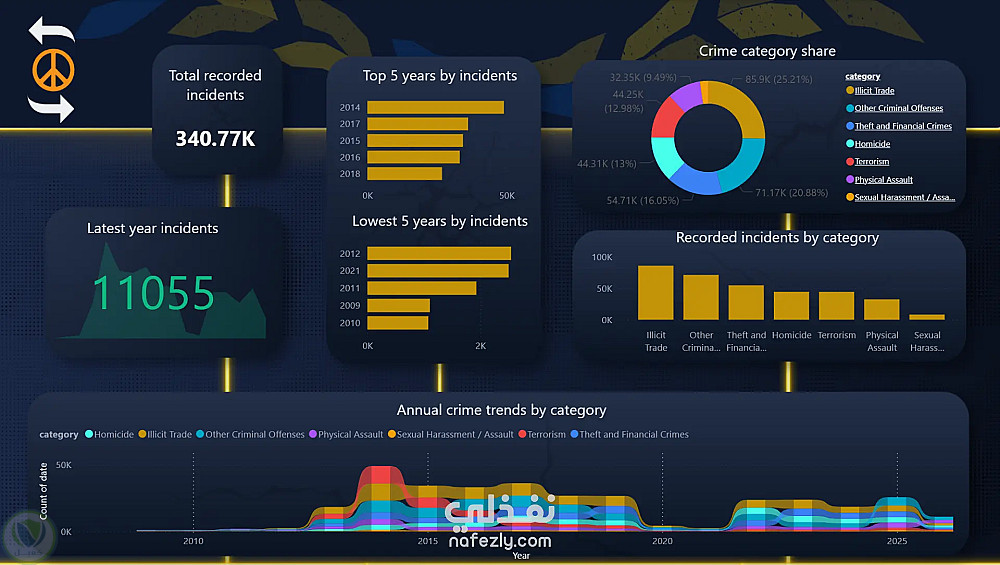
طورت نظام Web Scraping باستخدام Python لاستخراج وتجميع 567,512 سجلًا إخباريًا من أرشيف اليوم السابع، من 2009 إلى 2026، ضمن مشروع بحثي فائز بجائزة UGRF لتحليل أنماط الجرائم والعنف الأسري في مصر.
مراحل التنفيذ:
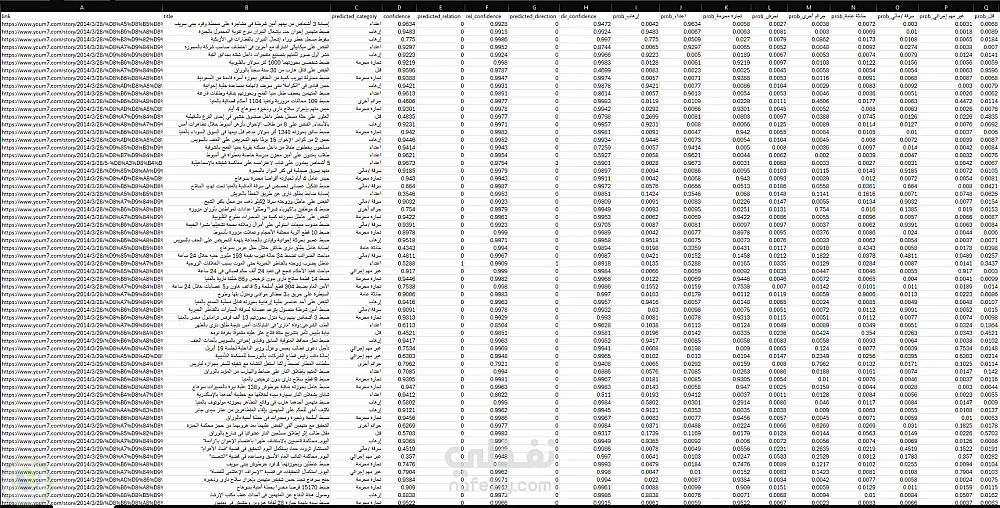
• جمع الأخبار والروابط والبيانات آليًا، مع التعامل مع آلاف الصفحات والـPagination.
• تنظيم البيانات في Dataset من 4 أعمدة تغطي أكثر من 16 عامًا.
• معالجة البيانات الناقصة ومراجعة التكرارات وتنظيف النصوص العربية باستخدام Pandas.
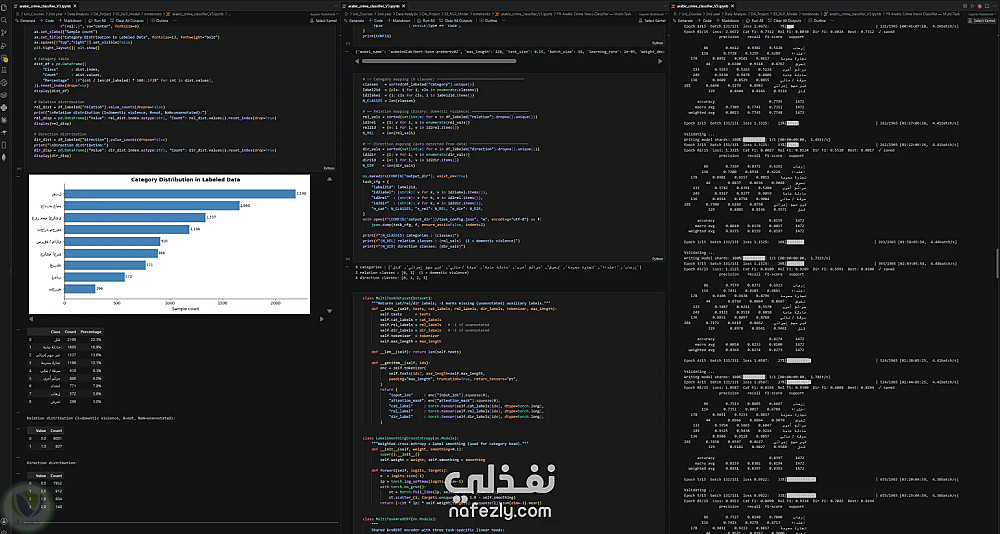
• تجهيز البيانات للتحليل الإحصائي وتدريب نماذج NLP وMachine Learning.
التقنيات: Python | Web Scraping | BeautifulSoup | Requests | Pandas | Data Extraction | Data Cleaning | CSV
النتيجة: تحويل آلاف صفحات الويب إلى قاعدة بيانات ضخمة ومنظمة وجاهزة للتحليل، والمساهمة في مشروع بحثي فائز بجائزة UGRF.
التفاصيل
| المشاهدات | 1 |
| المفضلة | 0 |
| القسم | برمجة, تطوير المواقع و التطبيقات |
حساب المستخدم
بائع مستوي: جديد
| اخر ظهور: منذ 51 دقيقة
أنا عبد الرحمن أمين، طالب علوم حاسب ضمن برنامج الذكاء الاصطناعي بجامعة النيل. أعمل على تحويل البيانات والأفكار التقنية إلى تحليل واضح وحلول عملية باستخدام ....
وظفني