 العربية
 English
تصنيف المراجعات النصية إلى إيجابي/سلبي
منذ أسبوعين
عرض العمل
الوصف
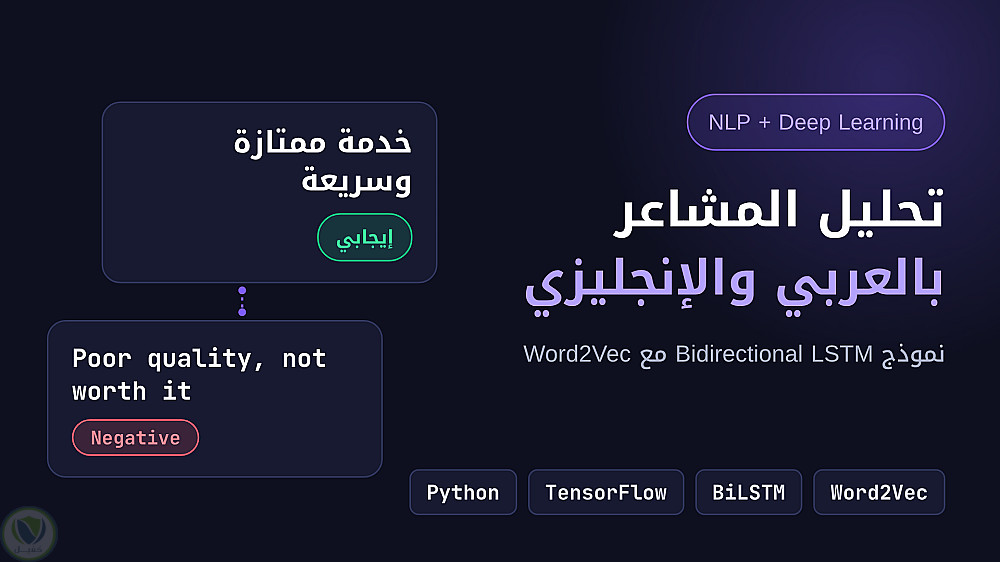
مشروع تحليل المشاعر ثنائي اللغة (عربي/إنجليزي) باستخدام معالجة اللغة الطبيعية (NLP) والتعلم العميق (Deep Learning)، حيث تم بناء نموذجين منفصلين لتصنيف النصوص إلى إيجابية أو سلبية اعتمادًا على مراجعات حقيقية باللغتين.
شملت المعالجة تنظيف النصوص من الرموز غير المرغوبة، وتوحيد الحروف العربية (الألف، الهمزات، التاء المربوطة)، وإزالة التشكيل والتطويل.
تم تدريب نموذج Word2Vec مخصص لكل لغة ودمجه في طبقة Embedding تغذي شبكة Bidirectional LSTM متعددة الطبقات، مع Dropout وEarly Stopping وReduce Learning Rate لتجنب الـ Overfitting.
قُيّمت النماذج بمقياس الدقة وتقرير التصنيف (Classification Report)، مع رسوم لمنحنيات الدقة والخسارة ومصفوفة الالتباس ومقارنة الأداء بين اللغتين. وحُفظت النماذج بصيغة قابلة لإعادة الاستخدام في أي تطبيق.
التقنيات المستخدمة: Python, TensorFlow/Keras, Gensim, Pandas, NumPy, Scikit-learn, Matplotlib, Seaborn
التفاصيل
| المشاهدات | 1 |
| المفضلة | 0 |
| القسم | برمجة, تطوير المواقع و التطبيقات - اخري |