 العربية
 English
(Web Scraping Current Weather Data from NOAA using BeautifulSoup & Pandas)
منذ أسبوع
عرض العمل
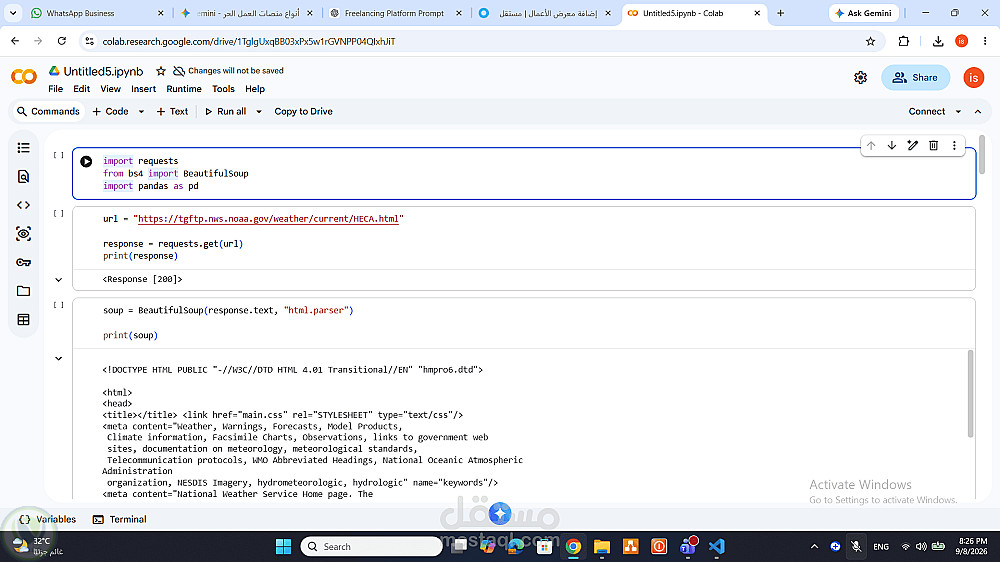
الوصف
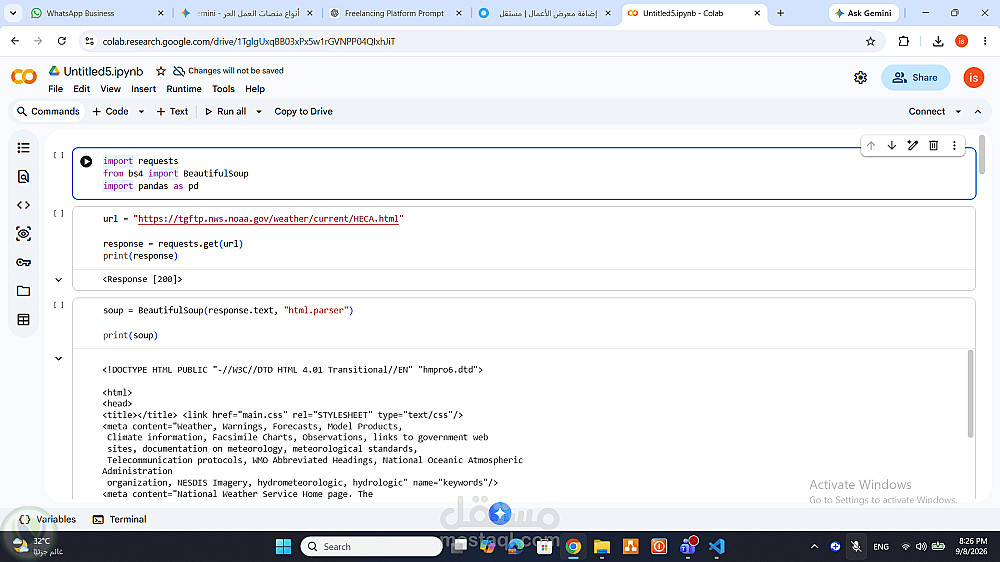
يقوم هذا المشروع باستخراج البيانات المتعلقة بحالة الطقس الحالية والسجل التاريخي لآخر 24 ساعة لمطار القاهرة الدولي (HECA) المتاحة على الهيئة الوطنية للمحيطات والغلاف الجوي (NOAA). يتضمن العمل الخطوات التالية: جلب البيانات (Data Retrieval): استخدام مكتبة requests لإرسال طلب HTTP لصفحة الطقس الخاصة بـ NOAA والحصول على نص الـ HTML. تحليل الـ HTML (HTML Parsing): استخراج عناصر الصفحة وتفكيك الجداول النصية باستخدام مكتبة BeautifulSoup. معالجة البيانات وتنظيفها (Data Extraction & Cleaning): البحث عن صفوف الجداول (<tr> و <td>) وتنظيف النصوص من الفراغات والكلمات الإضافية لاستخلاص المقاييس الأساسية مثل: الوقت، درجة الحرارة، نقطة الندى، الضغط الجوي، سرعة واتجاه الرياح، وحالة الطقس. هيكلة البيانات (Data Structuring): تحويل البيانات المستخرجة إلى DataFrame بواسطة مكتبة pandas لتجهيزها للتحليل أو الحفظ.
التفاصيل
| المشاهدات | 0 |
| المفضلة | 0 |
| القسم | أمور اخرى |