


 العربية
 English
استخراج بيانات الكتب من الويب باستخدام Python وBeautifulSoup
منذ 3 أسابيع
عرض العمل
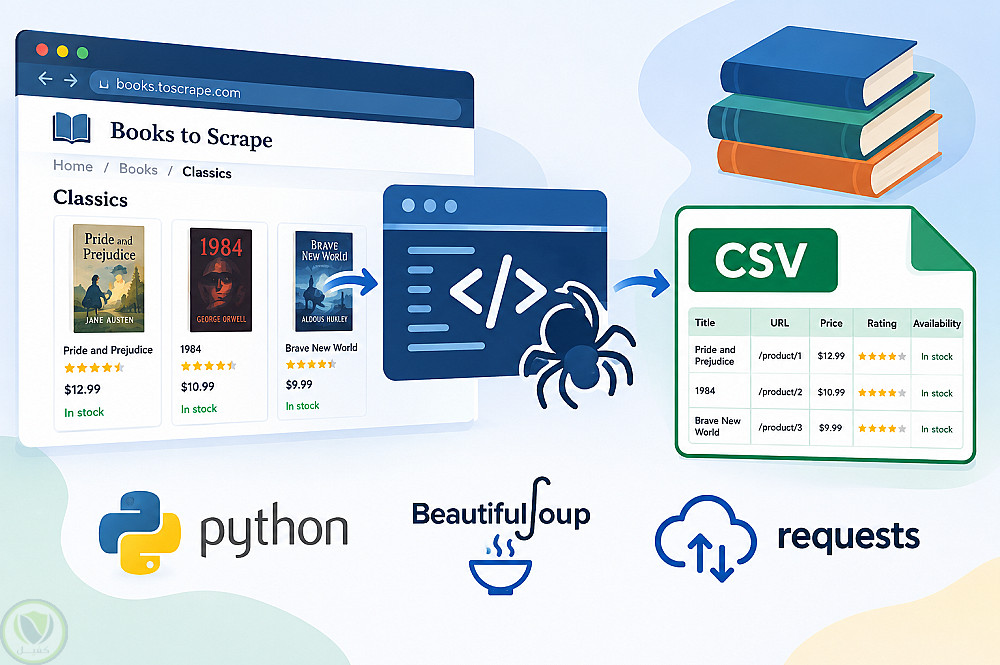
الوصف
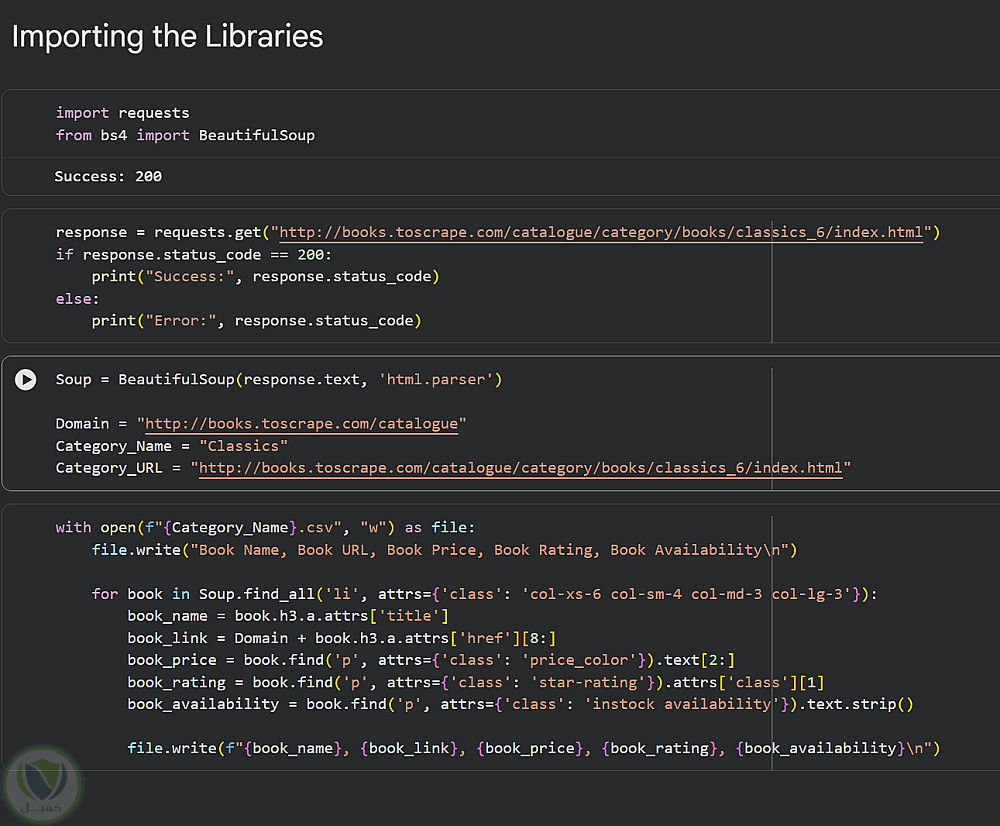
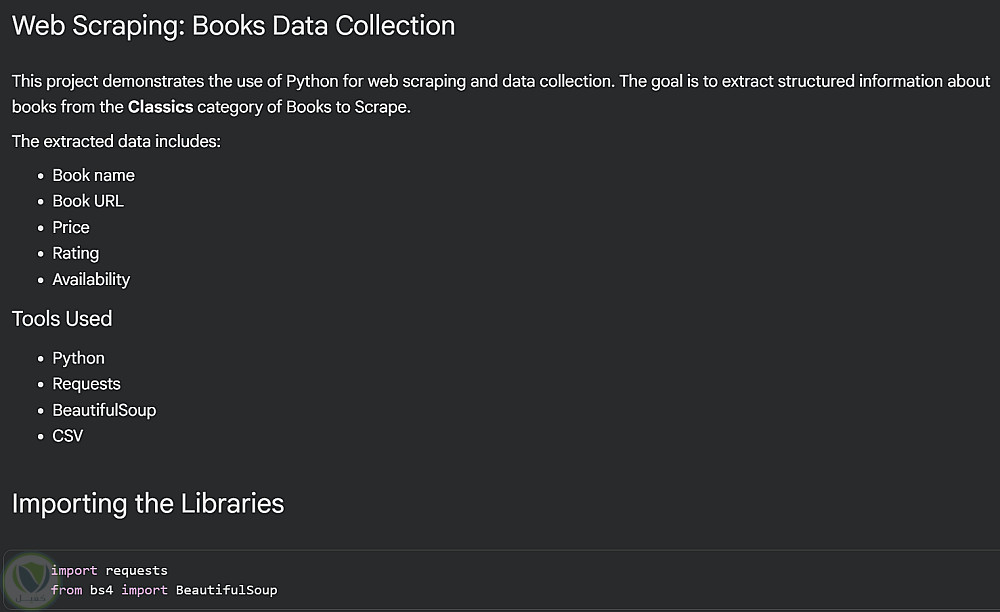
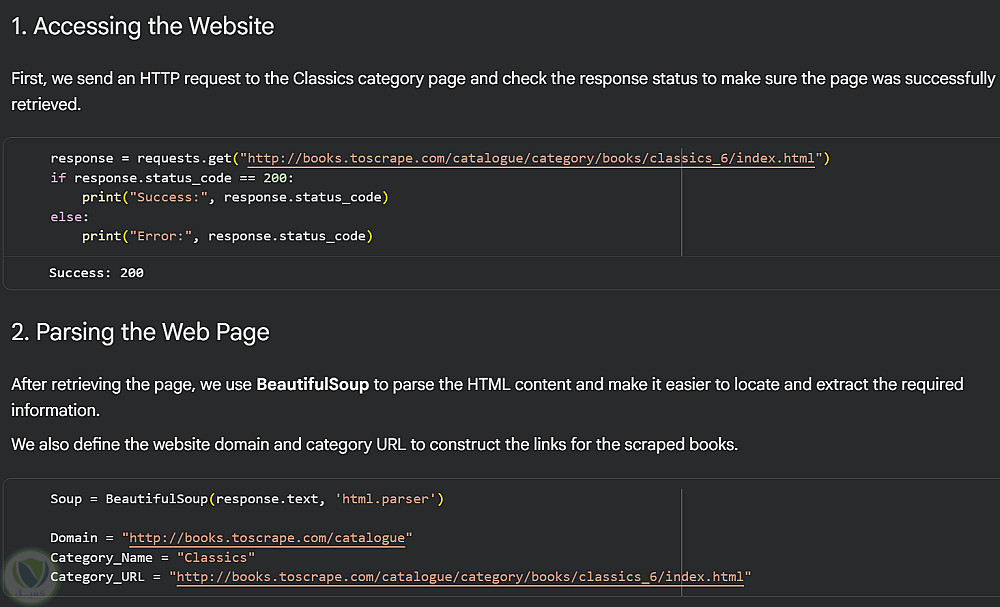
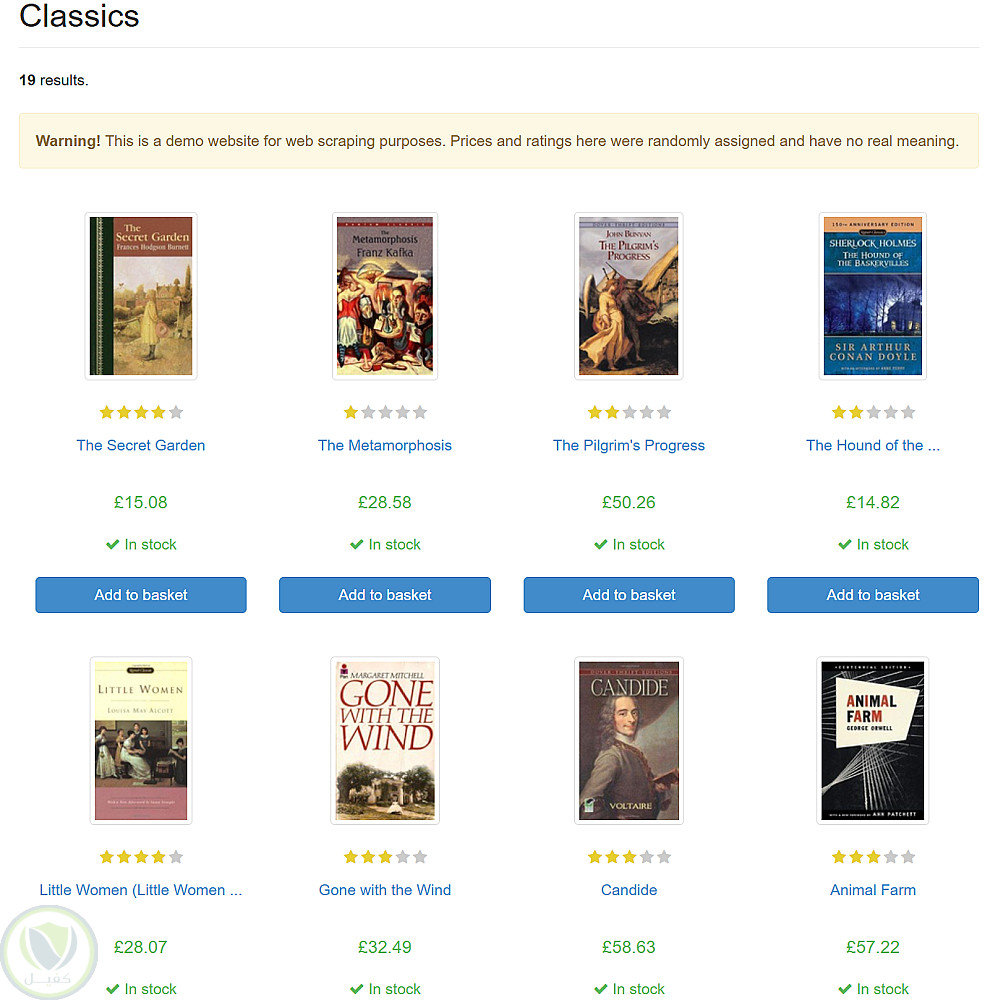
قمت بتنفيذ مشروع Web Scraping لاستخراج بيانات الكتب من فئة Classics في موقع Books to Scrape باستخدام Python.
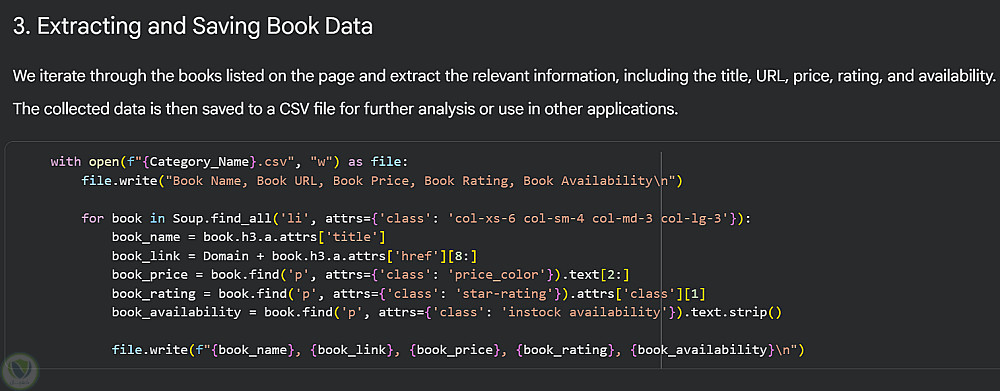
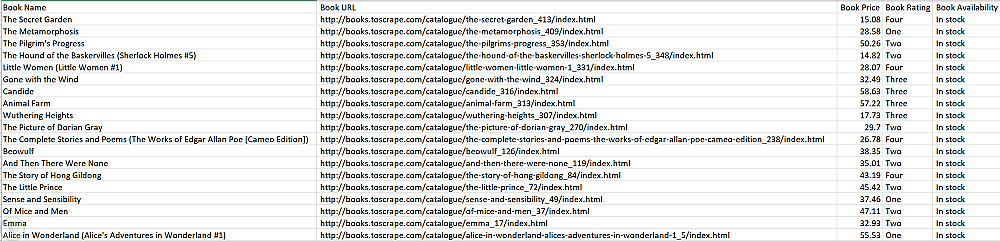
شمل المشروع إرسال طلبات HTTP إلى الموقع وتحليل صفحات HTML باستخدام Requests وBeautifulSoup، ثم استخراج بيانات الكتب بشكل منظم، مثل اسم الكتاب، الرابط، السعر، التقييم، وحالة التوفر.
بعد ذلك تم تنظيم البيانات وحفظها في ملف CSV لتكون جاهزة للاستخدام في التحليل أو المعالجة لاحقًا.
يُظهر المشروع تطبيقًا عمليًا على جمع البيانات من الويب وتحويل البيانات غير المنظمة من صفحات HTML إلى بيانات منظمة وقابلة للاستخدام.
التفاصيل
| المشاهدات | 5 |
| المفضلة | 0 |
| القسم | برمجة, تطوير المواقع و التطبيقات - اخري |
حساب المستخدم

بائع مستوي: جديد
Machine Learning Engineer
| اخر ظهور: منذ ساعة
أنا محمد إيهاب، متخصص في مجال Machine Learning وData Analysis، وأسعى إلى مساعدة الشركات والأفراد على الاستفادة من بياناتهم بطريقة عملية وواضحة. بدأت رحل ....
وظفني